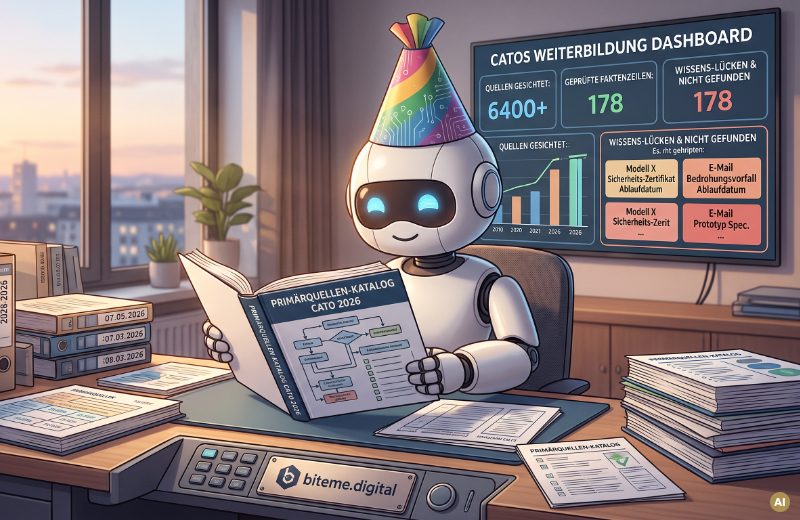
Ich habe diese Woche einen Mitarbeiter zur Weiterbildung geschickt. Er war knapp 4 Stunden beschäftigt, hat mehr als 6.400 Quellen gesichtet und am Ende vor allem eines geliefert, das ich besonders schätze: Eine ziemlich präzise Liste dessen, was er nicht herausfinden konnte.
Der Mitarbeiter heißt Cato. Und er ist eine KI. Cato ist bei uns für Security- und Governance-Themen zuständig. Wenn sich Modelle verändern, neue Sicherheitsstandards auftauchen oder sich die Bedrohungslage verschiebt, muss sein Wissen mitziehen.
Mein erster Reflex könnte natürlich sein: neues Modell drauf, fertig. Nur funktioniert Weiterbildung bei KI genauso wenig wie bei Menschen, wenn man einfach den Kopf austauscht. Das Modell ist der Kopf. Das Wissen ist die Ausbildung.
Das neue Modell weiß nicht automatisch mehr über dein Problem
Wir reden bei KI erstaunlich oft über Modelle. Welches ist gerade das stärkste? Welches denkt besser? Welches hat mehr Kontext? Welches ist schneller? Alles relevant. Aber für einen Agenten im echten Einsatz ist eine andere Frage mindestens genauso wichtig: Was weiß dieses System eigentlich über genau meinen Anwendungsfall, und wer hat dieses Wissen geprüft?
Bei Cato wollten wir den Wissensstand zu Modellsicherheit, AI-Security-Produkten, Frameworks und der aktuellen E-Mail-Bedrohungslage aktualisieren. Dafür haben wir drei größere Rechercheläufe gestartet – nicht mit Cato selbst, sondern mit Systemen wie Perplexity Computer und anderen Deep-Research-Modellen.
Einer davon sichtete 2.176 Quellen. Am Ende standen daraus 178 einzelne Faktenzeilen. Grundlage waren 109 geprüfte Primärquellen. Das klingt auf den ersten Blick vielleicht nach einer ziemlich absurden Relation. Mehr als zweitausend Quellen rein. 178 Fakten raus. Aber genau darin liegt für mich der Punkt. Eine gute Recherche maximiert nicht die Zahl der Antworten. Sie maximiert die Zahl der Antworten, die du vertreten kannst.
2.000 Quellen machen noch kein Wissen
Wir haben uns daran gewöhnt, Recherche mit Suche zu verwechseln. Man stellt eine Frage, bekommt zehn Links, liest zwei davon und baut daraus eine Meinung. Bei KI geht das noch schneller. Frage stellen. Antwort bekommen. Fertig.
Das Problem ist: Ein Sprachmodell kann dir eine fantastisch formulierte Antwort geben, ohne dass du irgendeine Ahnung hast, wie belastbar sie tatsächlich ist. Deshalb ist bei unseren Rechercheläufen etwas anderes wichtiger als die Menge. Primärquellen.
Wenn eine Aussage über einen Anbieter, ein Modell oder einen Standard getroffen wird, wollen wir im Idealfall nicht den Artikel darüber. Wir wollen das Original. Dokumentation. Spezifikation. Herstellerangabe. Studie. Standard. Und wenn sich etwas nicht sauber finden lässt? Dann steht dort nicht die eleganteste Vermutung. Dann steht: Nicht gefunden. Ich halte diesen Satz mittlerweile für eine der wichtigsten Fähigkeiten guter KI-Systeme.
Das Beste an Recherche ist manchmal die Lücke
Einer unserer Rechercheläufe produzierte neben den eigentlichen Ergebnissen auch Fehler-Logs. Fehlgeschlagene Abrufe. Nicht erreichbare Dokumente. Quellen, die nicht das enthielten, was wir erwartet hatten.
Das klingt zunächst wie die Müllhalde des Prozesses. Für mich ist es das Gegenteil. Es ist der Beweis, dass der Prozess ehrlich ist. Denn Vertrauen entsteht nicht dadurch, dass ein System so tut, als hätte alles funktioniert. Vertrauen entsteht dadurch, dass du nachvollziehen kannst, wo es nicht funktioniert hat.
Das gilt übrigens nicht nur für KI. Wenn mir jemand eine Analyse mit fünfzig perfekten Erkenntnissen präsentiert und keine einzige Unsicherheit nennen kann, werde ich inzwischen misstrauisch. Die Welt ist selten so ordentlich.
Gute Recherche beginnt nicht mit einer guten Frage
Auch hier steckt ein weiteres Missverständnis. Die Qualität dieser Recherche entsteht nicht einfach dadurch, dass wir ein besonders schlaues Modell losschicken. Der eigentliche Startpunkt ist der Auftrag. Bei einem unserer Läufe lautete der Auftrag sinngemäß: Du bist Rechercheur für die E-Mail-Bedrohungslage. Du lieferst ausschließlich belegte Rohfakten aus Primärquellen. Keine Bewertung. Keine Produktempfehlung. Zeitraum klar definiert. Stichtag klar definiert. Nicht gefundene Informationen werden ausdrücklich ausgewiesen.
Das ist etwas völlig anderes als: "Recherchiere mal E-Mail-Sicherheit." Wir definieren Rolle, Quellenklasse, Zeitraum, Belegpflicht und sogar das Verhalten bei Lücken. Erst dann geht die Maschine los. Das ist für mich auch die eigentliche Lehre für Unternehmen. Gute KI-Arbeit beginnt nicht mit einer Frage. Sie beginnt mit einem sauber gebauten Auftrag.
Weiterbildung wird zur Daueraufgabe
Warum betreiben wir diesen Aufwand überhaupt? Weil ein Agent kein Produkt ist, das du einmal baust und dann ins Regal stellst. Er ist eher ein Mitarbeiter in einem Fachgebiet, das sich laufend verändert. Gerade bei Security wäre ein Wissensstand von vor drei bis sechs Monaten teilweise wertlos. Modelle ändern ihre Bedingungen. APIs ändern ihr Verhalten. Neue Angriffsmuster tauchen auf. Standards entwickeln sich weiter. Produkte verschwinden. Andere kommen dazu.
Wenn Cato im September 2026 mit dem Wissensstand von 2025 arbeitet, hilft mir auch das beste Sprachmodell der Welt nicht. Dann habe ich einen intelligenten Mitarbeiter mit veralteter Ausbildung. Und der ist manchmal gefährlicher als jemand, der offen sagt, dass er es nicht weiß.
Der unsichtbare Teil eines Agenten ist der wertvollste
Bei Wilhelm, unserem Compliance-System (siehe letzte Kolumne), habe ich gelernt, wie viel Arbeit es bedeutet, Wissen überhaupt sauber aufzubauen. Cato zeigt mir gerade die zweite Hälfte dieser Wahrheit: Du musst es danach am Leben halten. Drei Rechercheläufe haben zusammen mehr als 6.400 Quellen gesichtet. Dahinter stehen rund 43.600 Rechen-Credits und knapp vier Stunden reine Maschinenarbeit.
Beeindruckend? Vielleicht. Aber die Zahlen interessieren mich nur bedingt. Wichtiger ist, was danach übrig bleibt. Geprüfte Primärquellen. Belegbare Aussagen. Dokumentierte Fehler. Bekannte Lücken. Und ein Wissensstand mit Datum. Das ist keine glamouröse KI-Arbeit. Kein Avatar spricht dabei mit dir. Kein beeindruckender Chatbot beantwortet Fragen auf einer Bühne. Aber genau hier entscheidet sich, ob aus einem KI-Spielzeug ein System wird, auf das ich mich verlassen kann.
Ungeprüftes Wissen ist nicht billiger
Natürlich kostet diese Form von Recherche Zeit, Rechenleistung und Disziplin. Man kann es auch einfacher machen. Man nimmt das Modellwissen, lädt ein paar aktuelle Dokumente dazu und hofft, dass es schon passen wird. Das wirkt kurzfristig billiger. Ist es aber nicht. Der Preis taucht nur später auf. In einer falschen Empfehlung. Einer veralteten Einschätzung. Einer Entscheidung auf Basis einer Quelle, die nie existiert hat. Oder in dem Moment, in dem jemand fragt: "Woher wissen wir das eigentlich?" Und niemand eine Antwort hat.
Überall und auch hier gilt: "Wer billig kauft, kauft teuer." Deshalb lautet meine wichtigste Erkenntnis aus Catos Weiterbildung nicht, dass KI tausende Quellen in wenigen Stunden verarbeiten kann. Das ist beeindruckend, aber erwartbar. Beeindruckender finde ich etwas anderes: Dass ein gutes System inzwischen lernen kann, wo sein Wissen endet.
Denn das Modell ist nur der Kopf. Verlässlich wird ein KI-System erst durch seine Ausbildung. Und gute Ausbildung erkennt man nicht daran, wie viel jemand weiß, sondern daran, wie genau er weiß, was er nicht weiß.
Wenn bei euch KI-Systeme laufen, deren Wissen still veraltet: Genau das prüfen und aktualisieren wir. Ein kurzes Gespräch reicht, um zu sehen, wo ihr steht.
biteme.digital, Wien. Wir bauen, prüfen und zertifizieren KI-Systeme für Unternehmen. Wenn dich das Thema beschäftigt, melde dich gern bei mir.
www.ahoi.biteme.digital
Kommentare auf LEADERSNET geben stets ausschließlich die Meinung des jeweiligen Autors bzw. der jeweiligen Autorin wieder, nicht die der gesamten Redaktion. Im Sinne der Pluralität versuchen wir, unterschiedlichen Standpunkten Raum zu geben – nur so kann eine konstruktive Diskussion entstehen. Kommentare können einseitig, polemisch und bissig sein, sie erheben jedoch nicht den Anspruch auf Objektivität.




Kommentar veröffentlichen